20 ajustes pouco comentados que turbinam chatbots com IA
Pequenas alavancas técnicas podem multiplicar a qualidade e reduzir o custo do seu chatbot com IA. Veja 20 configurações práticas, como funcionam e como aplicar no dia a dia da sua PME.
Victor Hugo Nogueira
·5 min de leitura
Neste artigo · 4 seções
Chatbots com IA já respondem bem a perguntas genéricas, mas é nas bordas — regras de geração, busca, memória e orquestração — que mora a performance de verdade. Para uma PME, isso significa reduzir custo por conversa, cortar tempo médio de atendimento e aumentar satisfação sem trocar de modelo todo mês.
Performance de IA em chatbot não é só escolher o modelo; é 80% engenharia de configuração invisível.
Por que pequenas configurações mudam tudo
Modelos de linguagem são sistemas probabilísticos: pequenas mudanças em como você amarra entrada, contexto e decodificação alteram fortemente coerência, precisão factual e latência. Em aplicações de negócio (FAQ, suporte, cobrança, vendas), a cadeia envolve: coleta do histórico do usuário, recuperação de dados internos (RAG), chamada ao modelo, ferramentas externas (ERP/CRM), filtros e cache. Cada elo tem parâmetros com efeitos compostos.
Como essas alavancas funcionam (sem mistério)
Três camadas concentram as “alavancas”: geração, recuperação e orquestração.
- Geração: controla criatividade, verbosidade e formato (respostas consistentes vs. soltas).
- Recuperação (RAG): define o que entra no contexto — documentos certos, no tamanho certo, com a ordem certa.
- Orquestração: trata de tempo, custo, reuso (cache), concorrência e quedas controladas (fallbacks).
Tabela rápida para entender ajustes de amostragem:
| Parâmetro | O que controla | Quando usar | Risco |
|---|---|---|---|
| Temperatura | Aleatoriedade global por token | Escrever variações de texto, brainstorming | Alucinação em tarefas factuais |
| Top-p | Probabilidade cumulativa do conjunto de tokens considerados | Refinar diversidade mantendo coerência | Cortar tokens raros necessários |
| Top-k | Número fixo de candidatos por passo | Restringir escolhas em prompts muito abertos | Repetição/empobrecimento do texto |
20 configurações práticas e pouco faladas
- Temperatura x Top-p sincronizados: para FAQ e suporte, use temperatura 0.0–0.3 com top-p 0.9–1.0; para vendas consultivas, 0.5–0.7 com top-p 0.8–0.95. Ajuste ambos, não só um.
- Top-k (quando disponível): fixe k=20–50 para cortar rabos longos de distribuição em prompts abertos. Em tarefas estritas, deixe desativado para não empobrecer.
- Frequency vs. Presence penalty: presence>0 encoraja novos tópicos; frequency>0 reduz repetição. Em chat de suporte, frequency 0.2–0.6 diminui loops e “enrolação”.
- Max_tokens de saída com compressão: limite de 150–300 tokens reduz custo e força objetividade. Combine com instruções de “responda em até 5 linhas”.
- Stop sequences: defina paradas como "\n\nHumano:", "</fim>" para cortar vazamentos de persona e acelerar respostas. Em JSON, pare em "\n\n" para não derramar texto livre.
- Truncamento inteligente do contexto: preserve cabeçalho de instruções e dados mais recentes do usuário; corte do meio usando janela deslizante. Evite truncar o “sistema”.
- Chunk size e overlap no RAG: para artigos/FAQs, 300–500 tokens com overlap de 10–20% equilibra contexto e precisão; para catálogos curtos, 100–200 sem overlap já basta.
- Embeddings: modelo e normalização: use embeddings compatíveis com seu idioma (pt-BR) e normalize vetores (L2) para distância de cosseno coerente. Atualize embeddings ao mudar tokenizador.
- Índice vetorial (HNSW/IVF) e parâmetros: em HNSW, comece com M=16 e efSearch=100; aumente efSearch só se recall cair. Em IVF-Flat, ajuste nlist conforme volume (√N é regra prática).
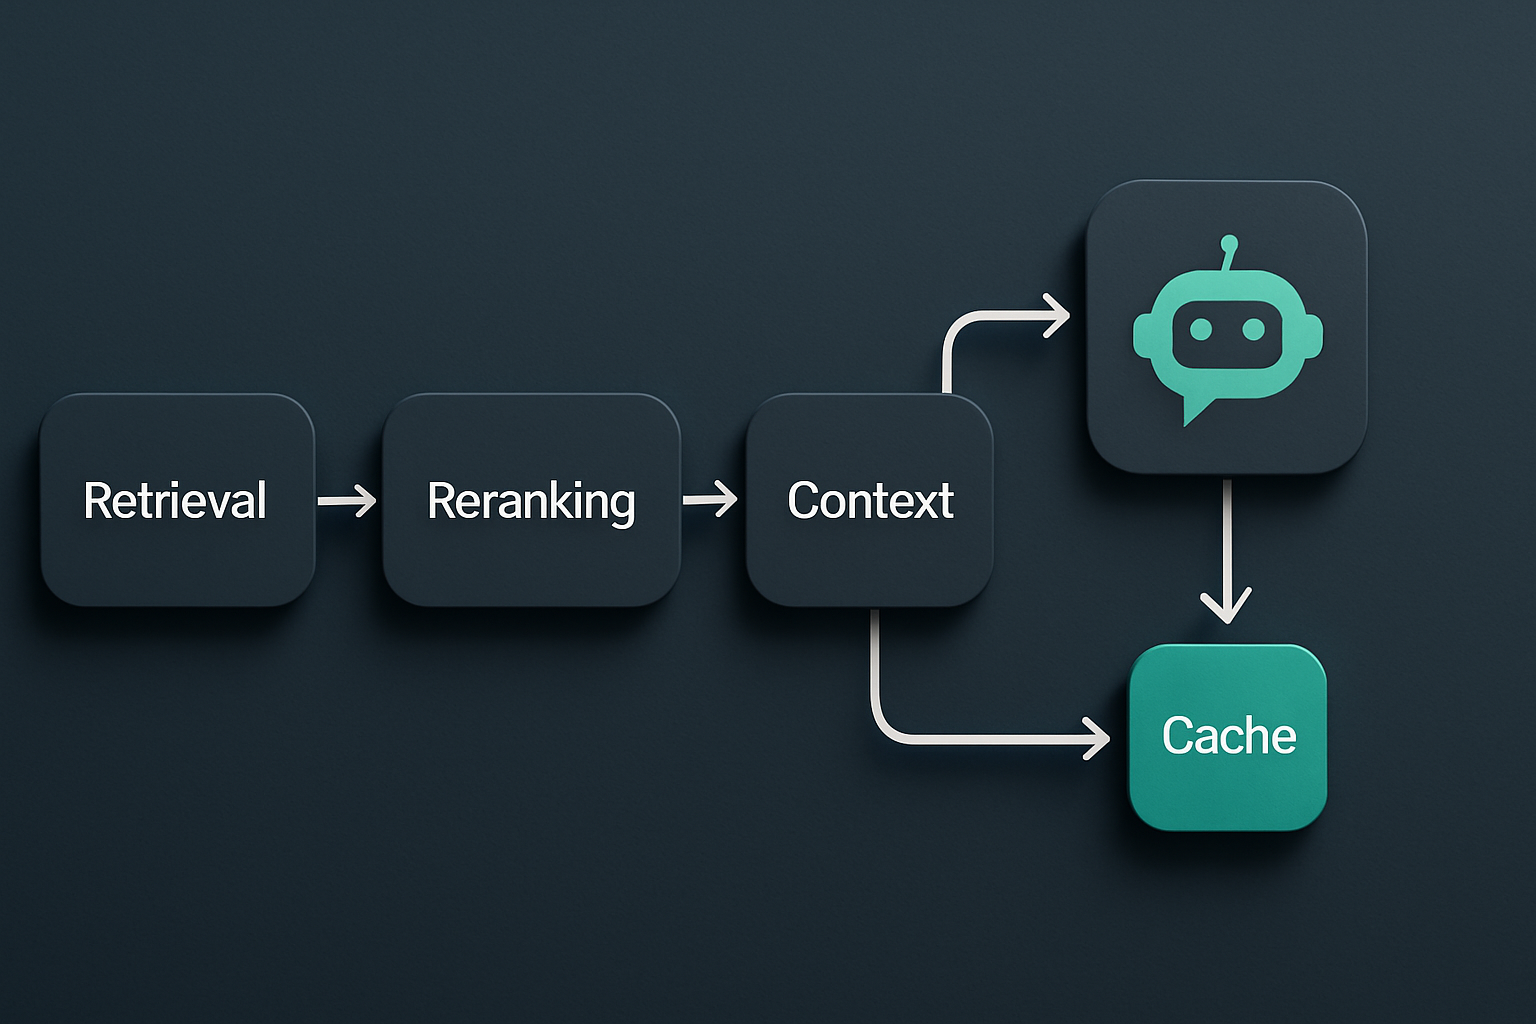
- Reranking cruzado (cross-encoder): após recuperar top-20 por similaridade, reranqueie e mantenha top-3 a top-5. Aumenta precisão factual sem inflar contexto.
- Cutoff por similaridade: defina um score mínimo (ex.: 0.25–0.35 em cosseno). Abaixo disso, peça esclarecimento ao usuário. Reduz alucinação baseada em documento irrelevante.
- Cache semântico e TTL: armazene respostas de prompts idênticos ou equivalentes por 30–120 min (FAQs quentes). Use hash do prompt + versão do sistema + top-k de docs.
- Contexto de sessão com slots: reserve slots fixos para “dados estáticos” (políticas, preços-base) e slots rotativos para “interações recentes”. Evita expulsar fatos críticos em conversas longas.
- Tool calling com esquema estrito: descreva funções com JSON Schema (tipos, enums, ranges). Força o modelo a retornar parâmetros válidos e corta retrabalho da API externa.
- Decodificação determinística ao chamar ferramentas: temperatura=0, top-p=1 em passos de função. Variância aqui vira bug downstream.
- Timeouts e retries com backoff: defina 8–12 s por provedor, 2 tentativas com backoff exponencial + jitter. Aborte cadeia cara quando a etapa crítica falhar.
- Concorrência e janelas de batch: limite 4–8 requisições simultâneas por instância para evitar throttle. Agregue logs/telemetria em batch a cada 250 ms para reduzir I/O.
- Resumo de memória e ancoragem: a cada 12–15 turns ou 2k tokens, resuma o histórico em bullets e fixe “fatos do caso” num bloco permanente até fechar o ticket.
- Streaming e política de interrupção: habilite streaming para latência percebida menor e permita interromper geração quando o usuário envia nova mensagem. P95 < 1.5 s é bom alvo.
- Observabilidade e canário: ative métricas por versão de prompt/parâmetro (CSAT, FCR, custo, p95). Libere 5–10% de tráfego para a nova configuração e tenha rollback em 1 clique.
Como priorizar e medir na sua PME
- Comece pelo que afeta qualidade factual: itens 7–11 (RAG), depois 14–15 (tool calling). Em seguida, ajuste 1–4 (decodificação) e 12/19 (experiência/latência).
- Defina um orçamento de tokens por resposta (entrada+saída) e monitore custo por conversa. Substitua verbosidade por clareza: limite máximo + instrução de formato.
- Meça três métricas por versão: FCR (resolução na 1ª resposta), CSAT (amostral) e custo/conversa. Se FCR subir ≥5% com custo estável, promova a versão.
- Crie um playbook de fallback: se recuperação falhar (cutoff), peça clarificação; se ferramenta retornar erro, admita e ofereça rota humana.
- Revise semanalmente top-20 prompts/fluxos mais caros e aplique cache, truncamento e schema estrito.
Feito certo, esses 20 ajustes tiram seu chatbot do lugar-comum. Você não precisa do “maior modelo do mercado” para entregar resultado: precisa de disciplina de configuração, observabilidade e ciclos curtos de melhoria.
Escrito por
Victor Hugo Nogueira
Conteúdo da equipe ProspectIO sobre prospecção, automação e vendas B2B — o que aprendemos ajudando pequenas e médias empresas a montar sua máquina comercial.
Newsletter
Receba os próximos artigos por e-mail.
Um e-mail quando sair artigo novo sobre prospecção, funil e IA aplicada a vendas. Sem spam, e dá pra sair quando quiser.